¿Cómo se construye un sistema automático robusto?
Casi todo el mundo que empieza a investigar en trading algorítmico recorre el mismo camino. Una buena observación del mercado (un indicador que parece anticipar ciertos movimientos, un patrón que se repite con demasiada frecuencia como para ser casualidad) se convierte en código, el código se somete a un backtest, y el resultado decide si la idea sigue viva o se descarta. Es un proceso lógico. Es, de hecho, el que seguimos nosotros durante mucho tiempo.
Y también es, según descubrimos, un proceso incompleto.
Porque tarde o temprano (a ti te va a pasar igual que nos pasó a nosotros) llega una investigación que termina en una versión claramente mejor, y sin embargo apenas sabes explicar por qué funciona. O llega la contraria: una modificación que empeora los números, pero que durante el análisis te enseña algo del mercado que no habías visto antes. Cuando eso ocurre varias veces, empieza a quedar claro que el backtest no estaba respondiendo la pregunta que de verdad importaba.
Esa fue la duda que nos obligó a parar y repensar cómo investigamos en trading algorítmico. De ahí nació la metodología que hoy sostiene todo lo que vas a encontrar en BotLab Trading —y que vamos a construir aquí contigo, no solo para ti.
¿En qué momento empieza realmente una investigación?
La respuesta intuitiva es que una investigación empieza cuando se abre el editor de código: en ese momento, una idea deja de ser una posibilidad y pasa a ser algo que se puede poner a prueba. Nosotros pensábamos exactamente eso, hasta que empezamos a notar que las decisiones que de verdad importaban ya estaban tomadas mucho antes de escribir una sola línea.
Nuestro primer sistema, el que terminaría dando nombre a StochEMA, nació de una observación bastante simple: cuando un mercado mantiene una dirección clara, un retroceso acompañado de una recuperación del estocástico puede ofrecer una entrada con una relación asimétrica entre beneficio y riesgo. Sobre el papel, esa idea invita a programar directamente: detectar el retroceso, confirmar con el estocástico, entrar. Es lo que habríamos hecho unos años antes.
Pero una misma observación puede esconder investigaciones muy distintas. ¿El estocástico está detectando de verdad una pérdida de impulso, o solo funciona cuando el precio ya se mueve a favor de una tendencia dominante? ¿La ventaja real está en el punto de entrada, o en cómo se gestiona la salida una vez dentro de la operación? La idea seguía siendo la misma. Lo que cambiaba era la pregunta concreta que decidíamos responder primero… y esa elección terminó condicionando toda la investigación.
Antes de tocar el código dedicamos una parte importante del trabajo a explorar la idea, y es en ese momento donde solemos apoyarnos en una herramienta que quizá no esperes: la inteligencia artificial. No la usamos para que nos proponga estrategias rentables, sino para algo más incómodo y más útil: para que cuestione nuestras propias suposiciones. Cuando llevas horas mirando el mismo gráfico es muy fácil terminar viendo solo lo que confirma tu hipótesis inicial. Una conversación bien planteada rompe ese sesgo, señala riesgos que se te habían pasado y, muchas veces, termina dejándote con menos certezas de las que tenías al empezar. Que sea así no es un mal síntoma: normalmente significa que has dejado de buscar una respuesta rápida y has empezado a entender de verdad el problema.
¿Por dónde empezamos cuando tenemos diez buenas ideas?
Explorar una idea a fondo tiene una consecuencia curiosa: cuantas más vueltas le das, más ramificaciones aparecen. Con StochEMA nos pasó así. La observación inicial —EMA como filtro de tendencia, estocástico para el retroceso— podía convertirse en media docena de hipótesis distintas apenas empezamos a mirarla de cerca: ¿hacía falta exigir también fuerza de tendencia con un ADX? ¿la pendiente de la media móvil distinguía mejor una tendencia real de un rango plano? ¿el verdadero margen de mejora estaba en el trailing de la salida?
Aquí es donde tú, si estás empezando en el trading algorítmico, vas a sentir la misma tentación que sentimos nosotros: probarlo todo a la vez. Parece la forma más rápida de avanzar. El problema es que, en cuanto metes tres cambios en la misma versión, dejas de poder interpretar lo que ocurre. Si el resultado mejora, no sabes cuál de los tres cambios lo ha causado. Si empeora, tampoco. Y hay un riesgo todavía peor escondido ahí: el sistema puede empezar a ajustarse a los datos concretos que estás usando para probarlo, en lugar de capturar algo que de verdad se repite en el mercado. A eso se le llama sobreajuste, y es uno de los errores más comunes —y más difíciles de detectar a tiempo— en el desarrollo de sistemas automáticos.
Nuestra respuesta a ese problema tiene nombre propio: la Hipótesis Mínima Viable (HMV).
La HMV es la versión más simple posible de un sistema capaz de poner a prueba una única hipótesis. Nada más entra en esa versión. Todo lo demás se aplaza.
Es lo que protege la investigación de nuestras propias prisas. Cuando trabajamos sobre StochEMA, cada mejora posterior a la primera versión estable se construyó siguiendo esta regla —una hipótesis, una versión, un resultado interpretable. Cambiar el filtro de tendencia fue una HMV. Cambiar la frecuencia del trailing fue otra. Cambiar el filtro de volatilidad, otra distinta. Ninguna se mezcló con las demás, precisamente para poder saber, al final, qué había funcionado y qué no. Esa parte del recorrido —qué hipótesis sobrevivieron y cuáles no— la iremos documentando en detalle en Sistemas Automáticos, donde StochEMA tiene su propia ficha de investigación abierta.
Cuando tú te enfrentes a tu primera idea con diez ramificaciones posibles, la pregunta que te va a merecer la pena hacerte no es «¿cuál de estas versiones es mejor?», sino «¿cuál de estas preguntas puedo responder con más claridad primero?».
Lo que los datos tenían que decirnos
Definida la hipótesis, programar deja de ser un ejercicio creativo y se convierte en el puente entre esa hipótesis y los datos. Con la primera versión de StochEMA aprendimos esto de la forma más incómoda posible: el sistema compilaba, generaba señales sobre el papel, y en los primeros backtests apenas producía operaciones. En una de las pruebas largas aparecieron solo cuatro operaciones, y una sola de ellas concentraba casi todo el beneficio —un Profit Factor aparentemente enorme, pero sin ningún valor estadístico real detrás.
El problema era que habíamos acumulado demasiadas condiciones de entrada: tendencia, pullback, estocástico, confirmación estructural, distancia, orden pendiente. Cada filtro por separado tenía sentido; juntos, casi nunca coincidían. La corrección no fue añadir nada nuevo, sino flexibilizar la lectura del estocástico —dejar de exigir un cruce exacto en una única vela y aceptar una recuperación de impulso a lo largo de varias barras. Con ese único cambio, el sistema pasó de no operar prácticamente nunca a generar un volumen de señales suficiente para empezar a sacar conclusiones reales.
Poco después apareció el fallo que más nos enseñó de toda esta etapa. El backtest, que arrancaba con normalidad, dejaba de operar por completo a partir de octubre de 2023. Los logs eran claros: ownPositions = 0, ownPending = 1. Una orden pendiente que nunca llegaba a ejecutarse ni a cancelarse había bloqueado el sistema durante casi tres años enteros, porque la lógica no permitía generar nuevas señales mientras existiera una orden abierta. La solución fue añadir una expiración a las órdenes pendientes: 48 barras, 48 horas en H1. Y ese cambio, tan pequeño sobre el papel, fue lo que por fin permitió hacer una validación histórica de verdad.
Con esa corrección, StochEMA_V1_ESTABLE, probado en BTCUSD en H1 entre 2018 y 2026, dejó estos números como referencia: beneficio neto de 1.752,30 USD sobre un depósito inicial de 1.000, Profit Factor de 1,23, drawdown máximo de balance del 16,29%, Sharpe de 1,42 y 822 operaciones, con un acierto del 31,87% —es decir, un sistema que pierde más veces de las que gana, pero donde la ganancia media compensa con holgura la pérdida media. No es el resultado más espectacular que vas a ver en el mundo del trading algorítmico, y no pretende serlo: es el primer sistema que nació de esta metodología, y sus números están aquí precisamente para que puedas comprobarlos, no para impresionarte.
La misma lógica, sin tocar un solo parámetro, se probó también en XRPUSD. El resultado fue un Profit Factor de 0,06 y un drawdown del 97,72% —la cuenta, prácticamente destruida. No lo escondemos porque forma parte de la respuesta: BTC ofrece movimientos direccionales más persistentes, mientras que XRP genera más rupturas falsas y ruido, un comportamiento al que esta arquitectura concreta no se adapta bien. Esa validación negativa vale, para nosotros, tanto como cualquier resultado positivo —es la prueba de que el sistema no funciona «porque sí», sino en unas condiciones concretas que ahora conocemos.
Lo que queda cuando termina una investigación
Cuando el backtest habla y algunas hipótesis pasan a formar parte del sistema mientras otras se descartan, podría parecer que ahí termina el proceso. En realidad es justo donde empieza a acumular valor.
Descubrimos pronto que documentar el resultado no bastaba: si no anotábamos también por qué una hipótesis fallaba, terminábamos volviendo a probarla meses después, convencidos de que esta vez sí funcionaría. Nos pasó literalmente con la idea del ADX: la retomamos una segunda vez antes de recordar que ya la habíamos descartado por el mismo motivo. Desde entonces documentamos bastante más que un resultado: la pregunta inicial, la hipótesis exacta que intentábamos comprobar, el contexto de las pruebas, cómo interpretamos los datos y qué decidimos hacer con esa hipótesis. Esa disciplina es lo que evita que la siguiente investigación tenga que arrancar desde cero.
Con StochEMA, esa acumulación no fue lineal. Cada respuesta abría preguntas nuevas: si el ADX podía filtrar los mercados laterales, si la pendiente de la media móvil distinguía mejor una tendencia real de un rango, si un trailing más rápido protegía el beneficio sin sacrificarlo. Algunas de esas hipótesis se convirtieron de inmediato en la siguiente versión a probar. Otras quedaron aparcadas, a la espera de que otro hallazgo les diera sentido meses después.
A este movimiento, ni lineal ni circular, sino uno que vuelve una y otra vez sobre las mismas ideas pero nunca desde el mismo punto de comprensión, lo llamamos la Espiral del Conocimiento.
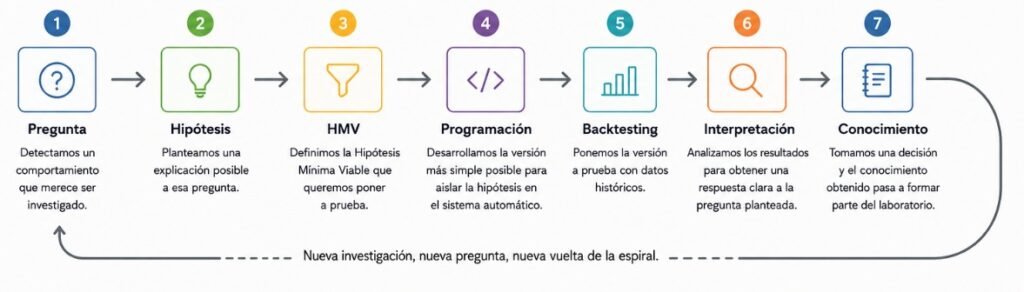
El dibujo de arriba es, probablemente, la imagen que mejor resume por qué trabajamos así: un sistema puede quedarse quieto —StochEMA_V1_ESTABLE, de hecho, está congelado a propósito como referencia fija—, pero lo que hemos aprendido investigándolo no deja de moverse ni de aplicarse a lo siguiente que investigamos, tenga o no tenga que ver con el estocástico o con las criptomonedas.
¿Por qué llamamos metodología a todo este proceso?
Durante un tiempo no llamábamos metodología a nada de esto. Simplemente investigábamos. Fue documentar muchas investigaciones seguidas lo que nos hizo notar un patrón que se repetía sin importar qué sistema tuviéramos entre manos: una pregunta inicial, una Hipótesis Mínima Viable, la versión más simple capaz de ponerla a prueba, el backtest, la interpretación de los datos y, por último, incorporar ese aprendizaje al laboratorio antes de formular la siguiente pregunta.
Ese recorrido dejó de ser, sin que lo planeáramos, una simple forma de trabajar y pasó a ser el marco de todo lo que hacemos en trading algorítmico. Su valor no está en prometerte mejores sistemas —eso nunca podemos garantizarlo—; está en obligarnos, a nosotros y a cualquiera que investigue con nosotros, a hacerlo siempre de la misma manera, sea cual sea la hipótesis sobre la mesa. La metodología no sustituye al pensamiento crítico. Lo protege de nosotros mismos.
A partir de aquí, cada diario de desarrollo, cada investigación y cada artículo metodológico que publiquemos en BotLab Trading va a seguir este mismo recorrido. Unos profundizarán en una sola fase. Otros documentarán una investigación completa, con sus hipótesis descartadas incluidas. Todos van a compartir el mismo propósito: mostrar no solo la conclusión, sino el camino (con sus callejones sin salida) que nos ha llevado hasta ella.
Conclusión
Empezábamos este artículo con una pregunta que parecía sencilla: ¿cómo se construye un sistema automático robusto?
Después de recorrer StochEMA de principio a fin (la idea, el bloqueo de tres años, la validación en BTC, el fracaso en XRP, las hipótesis que no sobrevivieron) la respuesta que tenemos hoy es bastante distinta de la que hubiéramos dado al principio. Un sistema robusto no depende de una idea brillante ni de una programación especialmente sofisticada, sino de un proceso de investigación en el que cada pregunta, cada hipótesis y cada decisión documentada suman un poco más de comprensión sobre cómo se comporta el mercado.
Toda versión nace para responder una pregunta. Toda respuesta puede convertirse en una nueva versión.
Esa frase, más que ningún otro párrafo de este artículo, resume lo que vas a encontrar en el resto de BotLab Trading. No es una colección de estrategias listas para copiar, sino una forma de investigar en trading algorítmico, con sus aciertos documentados igual que sus descartes. Por eso, cuando alguien nos pregunta cómo se construye un sistema automático robusto, ya no respondemos con una técnica ni con un indicador.
Respondemos con esta metodología.